Вторая линия техподдержки в нашей компании — это уже давно не только люди. Мы развернули пул AI-агентов L2, который круглосуточно разбирает обращения: исследует код и логи, находит причину, готовит исправление и черновик ответа — а человек только проверяет результат и отправляет его клиенту. Делимся, как это устроено и что из этого получилось.
Table Of Contents
Что такое пул L2 на агентах
Обращения второй линии — это не «перезагрузите и подождите». Это «акт не пришёл после подписания», «выгрузка падает с ошибкой», «не синхронизируется поле». Классически такие вещи стоят в очереди до свободного инженера.
У нас очередь общая, а работают по ней агенты. Каждое обращение проходит полный цикл: нормализация → исследование (в нескольких вариантах параллельно) → анализ → реализация → верификация → независимое ревью (три разных модели) → архивация. Типовой полный цикл занимает около двух с половиной часов — от «обращение появилось» до «готовое решение с доказательствами лежит перед человеком».
Выглядит это так — дашборд рабочего конвейера, все этапы завершены:
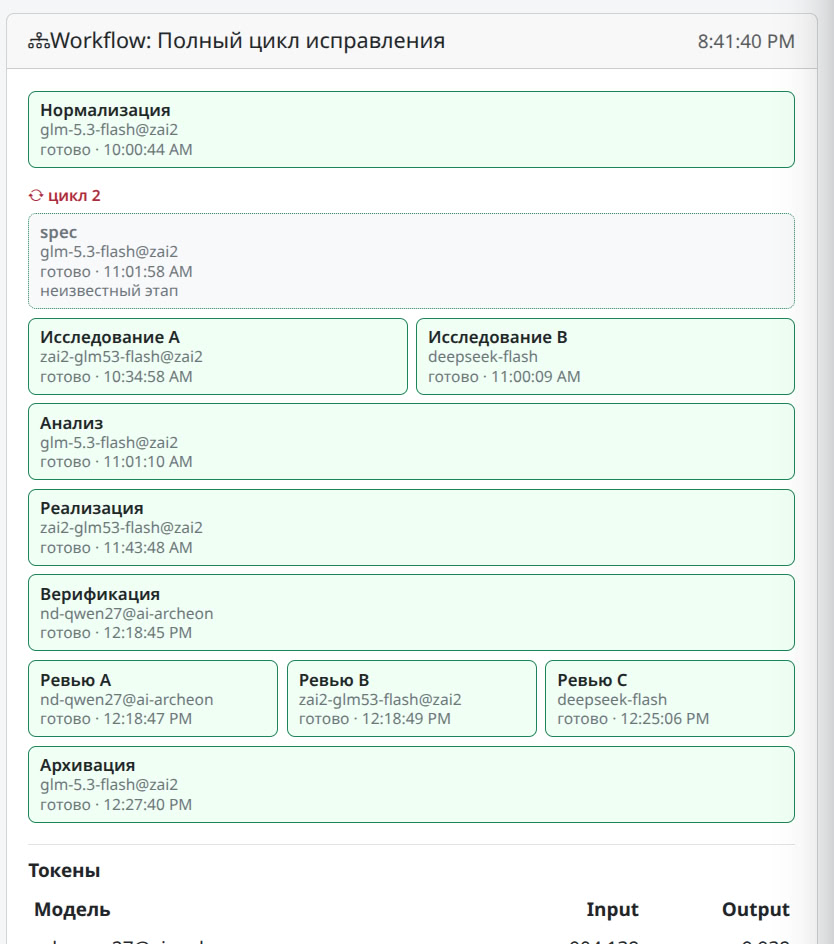
Обратите внимание на параллельные блоки: Исследование A/B и Ревью A/B/C выполняются одновременно разными моделями. Это принципиально — каждая модель ищет причину по-своему, а на ревью решение независимо проверяют три «глазами», прежде чем показать человеку.
Как устроен пул
За витриной support.archeon.io стоит несколько «полос» — независимых рабочих мест агентов. Очередь общая, кто свободен — тот берёт следующее обращение. Добавить мощность = добавить полосу, без переписывания процессов.
Весь опыт работы вынесен из промптов в скиллы — отдельные файлы-инструкции: типовые типы обращений, чек-листы проверки, шаблоны ответов, правила работы с конкретным продуктом. Скиллы живут в центральном хранилище и постоянно дополняются: система учится на каждом обращении, а не в головах отдельных инженеров.
Примеры диалогов
Ниже — сокращённые примеры из реальной работы (воспроизведены по мотивам обращений, детали обезличены).
Пример 1 — обращение по ЭДО:
Клиент: После подписания УПД контрагентом документ так и остался в статусе «Ожидает».
Агент: Проверил цепочку статусов на тестовом контуре и логи обработки. Причина: при повторной отправке документа после ошибки доставки статус не обновляется — обработчик пропускает событие повторного подписания. Подготовил исправление и тест. Черновик ответа: «Проблема воспроизведена, причина найдена, исправление войдёт в ближайшее обновление — документ отобразится корректно после установки».
Пример 2 — обращение по интеграции:
Клиент: Загрузка компаний из внешнего сервиса останавливается на середине, в логе «превышен лимит».
Агент: Воспроизвёл на своём стенде: лимит внешнего API стал жёстче. Добавил проверку лимита до отправки запроса и паузу между партиями — загрузка проходит полностью. PR готов, к ответу приложил лог успешного прогона.
Никакой магии — обычная инженерная работа, просто её выполняет агент, а человек читает готовый результат с доказательствами.
Какие модели показали себя лучше всего
Пул мультимодельный — на разных этапах работают разные «мозги». За три месяца боевой эксплуатации сложилась такая картина:
| Модель | Роль в пуле | Почему хороша |
|---|---|---|
| GLM-5.3-Flash (облако Z.ai) | Основная рабочая лошадка: нормализация, анализ, реализация, ревью | Быстрая и дешёвая, при этом уверенно держит инженерные задачи. Не боимся гонять её на каждый чих |
| DeepSeek V4 Flash | Исследование и анализ длинных материалов | Контекст до 1 млн токенов: целиком проглатывает логи, историю коммитов и переписку по обращению |
| Qwen3.8-27B (наш кластер) | Верификация и независимое ревью, скриншоты клиентов | Локальная модель на своём железе: независимые «глаза» + умение читать картинки из обращений |
Практика показала важную вещь: модель — не главное. Переключение между моделями почти не меняет качество, а вот качество скиллов и структура конвейера — меняют радикально. Мультимодельность нужна не ради качества как такового, а ради независимого ревью: три разные модели почти не «сговариваются» в ошибках.
Info
Хотите такой же пул поддержки под свои продукты — это наш профиль. Расскажите о задаче — развернём под ваш процесс.
Почему это круто
- 24/7 без утренних завалов. Обращение, пришедшее в ночь, к утру уже разобрано и ждёт проверки.
- Человек занимается только тем, что действительно требует человека — финальной проверкой и живым общением с клиентом.
- Каждое решение — с доказательствами: логи, ссылки на код, лог успешного прогона. Не «попробуйте ещё раз», а разбор.
- Масштабирование — это одна полоса, а не найм и онбординг.
Итог
Пул L2 на агентах мы развернули для себя — и он уже обрабатывает реальные обращения по всем нашим продуктам. Это работает на открытых моделях, частично на собственном железе, и складывается из трёх вещей: конвейер с независимым ревью, скиллы вместо промптов в головах и мультимодельность.
Как это устроено технически:
- Автономные агенты 24/7: от ошибки в мониторинге до PR — конвейер, из которого вырос пул;
- Корпоративные MCP — стандарт доступа агента к данным — как агент безопасно получает доступ к прод-базе, логам и коду.
Если нужна поддержка, которая не заставляет ждать утра, — напишите нам.