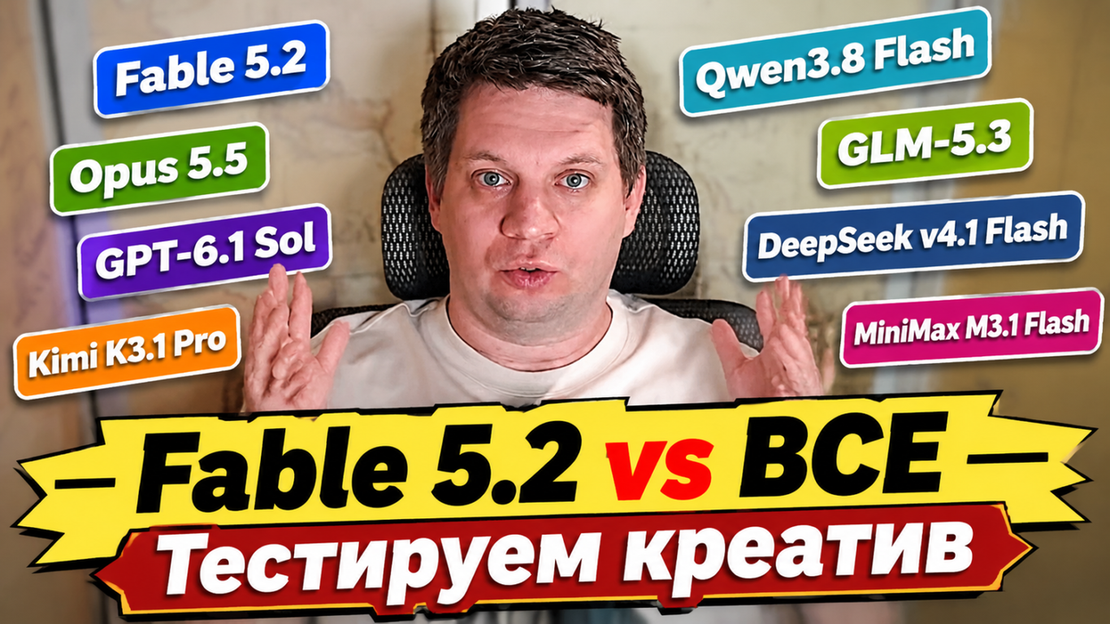
Одна задача. Один продукт. Восемь моделей. Мы проверяли не способность писать код и не умение считать токены, а то, ради чего шапка вообще существует: придумать фразу и картинку, на которые человек отреагирует.
В забеге — DeepSeek v4.1 Flash, Fable 5.2 (новинка, ради неё всё и затевалось), Opus 5.5, Kimi K3.1 Pro, Qwen3.8 Flash, GLM-5.3, MiniMax M3.1 Flash и GPT-6.1 Sol.
Видеоразбор теста · 11:09 · Rutube
Видеоразбор на нашем канале в Rutube. Ниже — та же история текстом, с цифрами и ссылками на все материалы.
Что за продукт
«Суды24» — приложение для Битрикс24, которое превращает CRM в юридическую. Главный модуль — интеграция с сайтами судов: дело попадает в карточку сделки само. Номер дела, инстанции, участники, движения, документы — всё в одном месте.
Боль, которую знает каждый юрист: сайты судов приходится обходить вручную, и о заседании человек узнаёт последним. Не потому что плохо работает, а потому что следить за десятками дел глазами невозможно.
Шапка страницы должна была не продать, а попасть в эту боль: остановить, заставить узнать себя и захотеть разобраться. Только первые два шага AIDA — внимание и интерес. Дальше уже не про шапку.
Что получила модель
Одинаковый вход для всех: описание продукта, боль пользователя и три скриншота страницы — текущая шапка, страница в светлой теме, страница в тёмной теме.
На выходе — пять вариантов, в каждом слоган до 28 знаков, текст на одно-два предложения и промпт для генератора. Стиль задан жёстко: плоский корпоративный комикс, современный, палитра сайта, центр кадра спокойный — поверх него накладывается кнопка Play.
Вызовы шли прямыми REST-запросами, без агента: что модель написала, то и ушло в генератор. Никаких «поправь сам» и «сделай красиво» между шагами. Картинки рисовал GPT-Image — 1,44 ₽ за кадр.
Почему тестов два
Первый заход был честным, но бессмысленным: в брифе мы перечислили пять тем — пропущенный срок, гора бумаг, ответ за десять секунд, спокойствие, диспетчерская. Восемь моделей послушно взяли эти пять тем, и получилось сорок вариантов одного и того же. Отличались формулировки, а не идеи: «Ответ за десять секунд» встретился у четырёх моделей подряд.
Это не глупость моделей, а следствие брифа: если в задании есть примеры, модель возьмёт примеры. Поэтому мы прогнали тест дважды с разными правилами.
Серия 1 — идеи придумывают модели. Убрали список тем, вместо него — матрица ограничений: пять слотов, у каждого свой тип идеи (предмет, сцена, цифра, цитата, антипаттерн), своя роль (корпоративный юрист, юрист фирмы, судебный представитель, арбитражный управляющий, директор) и свой момент (утро понедельника, ночь перед заседанием, отпуск). Повторять роль и момент нельзя, слова из брифа в слоган брать нельзя, плюс обязательное поле «чем идея отличается от типового B2B-лендинга».
Серия 2 — идеи заданы брифом. Вернули пять заданных тем, чтобы сравнить именно исполнение: все в равных условиях, различаются слоган, текст и кадр.
Что показала свободная серия: разнообразие появилось, но не абсолютное. Метафоры всё равно сходились — «Нить Ариадны» придумали две модели, «Вопрос директора» три. Свобода расширяет коридор, но не отменяет общих мест: все восемь моделей учились на одном и том же интернете.
Как судили
Сначала — слепое голосование моделей. Восемь контактных листов со всеми работами, под буквами A…H, без имён авторов. Каждая модель выбирала лучшую шапку из всех, включая свою — и себя при этом не узнавала.
Потом — юристы. Те же шапки показали людям, которые каждый день работают с делами и клиентами. Модели оценивают картинку и текст как картинку и текст; люди оценивают, сработает ли это на их клиента.
Итоги
Серия 1, свободные идеи. GLM-5.3 — 4 голоса из 8, Opus 5.5 — 2, Kimi K3.1 Pro и DeepSeek v4.1 Flash — по одному.
Серия 2, идеи по брифу. Fable 5.2 — 4 голоса из 8, GLM-5.3 — 2, Kimi K3.1 Pro и Opus 5.5 — по одному. При этом Fable 5.2 оба раза голосовала не за себя: и в свободной серии, и в серии с брифом её выбор уходил Kimi K3.1 Pro.
Смена правил сменила лидера — и это главный результат теста. «Лучшая модель» без указания правил ничего не значит.
Юристы рассудили иначе, чем нейросети:
- лучшая шапка целиком — GPT-6.1 Sol, «Не дежурьте у дела»: «Снова проверяете сайт суда перед сном?» — узнаваемая ситуация без давления и обещаний;
- лучшая картинка — Fable 5.2, «Заседание было вчера»;
- лучший текст — GLM-5.3, «Заседание не пройдёт мимо»;
- самая цепляющая картинка — MiniMax M3.1 Flash, «Одно окно — все дела». Модель, которая не собрала ни одного голоса в голосовании моделей.
Все 80 шапок, таблицы голосования, стоимость по каждой модели и галерея победителей — в отдельном разделе: итоги теста «Суды24».
Что заметили
Русский текст в кадре — сильный дифференциатор. Плашку с текстом заложила в промпт только Fable 5.2 — три варианта из пяти. Остальные нарисовали чистую иллюстрацию, хотя бриф это разрешал. Кадры с текстом собирают голоса: человек читает слоган прямо на картинке, не дожидаясь загрузки страницы.
Кнопку Play модели рисуют, если о ней упомянуть. В брифе было сказано: поверх центра накладывается кнопка Play. Часть моделей поняла это буквально и попросила генератор нарисовать плей-кружок в самом кадре — поверх настоящей кнопки сайта появился второй. Лечится не правкой картинок, а правкой задания: из промптов убрали упоминание плеера и добавили запрет на любые UI-элементы, все 80 кадров перегенерировали.
Формальное нарушение брифа одно: GLM-5.3 в четвёртом варианте выдал слоган на 30 знаков при лимите 28.
Сколько стоило
Весь тест — 134 ₽. Это две серии, 80 концепций и 80 картинок.
| Что | Серия 1 | Серия 2 | Всего |
|---|---|---|---|
| Вызовы моделей | 7,11 ₽ | 5,90 ₽ | 13,01 ₽ |
| Генерация картинок | 57,60 ₽ | 57,60 ₽ | 115,20 ₽ |
| Судейство | 0,89 ₽ | 4,96 ₽ | 5,85 ₽ |
| Итого | 65,60 ₽ | 68,46 ₽ | 134,06 ₽ |
Дороже всего не модели, а картинки: 115 ₽ из 134 ₽. Восемь вызовов с полным брифом и скриншотами — 13 ₽. Самая дорогая модель в наборе — Fable 5.2: 15,24 ₽ из 68,46 ₽ второй серии, потому что её вызов стоит 4,73 ₽ против 0,04–0,66 ₽ у остальных, и она дороже всех в судействе с картинками.
Что из этого следует
Картинка, текст и идея — три разные способности, и редко живут в одной модели. У Fable 5.2 — лучшая картинка по мнению юристов, у GLM-5.3 — лучший текст, у GPT-6.1 Sol — лучшая шапка целиком. И это три разные модели. Выбирать «одну модель на всё» — плохая стратегия: вы получаете её слабые места бесплатно.
Модель надо направлять. Разница между «сорок вариантов одного и того же» и «сорок разных идей» — это не модель, а бриф. Свобода без ограничений даёт общие места, ограничения без свободы — копирку. Работает матрица: тип идеи, роль, момент, запрет на слова из описания продукта.
Дальше — люди. Ни один вариант не собрал всех голосов: юристы взяли шапку у GPT-6.1 Sol, картинку — у Fable 5.2, текст — у GLM-5.3. Собирать финал из лучших частей — нормальная работа, а не признание теста неудачным.
Это дешево. 134 ₽ за полный прогон с судейством — это восемь минут работы дизайнера, если считать час за 1000 ₽. Если ваш процесс выглядит так: бриф → варианты моделей → отбор людьми → доводка руками, — то тест окупается на первой же странице.
Материалы
- Итоги теста «Суды24» — все таблицы, галерея и стоимость.
- Интерактивный дашборд — 80 шапок.
- Серия 1 — идеи придумывают модели и серия 2 — идеи заданы брифом.
- Все шапки одной темы — пять тем рядом.